
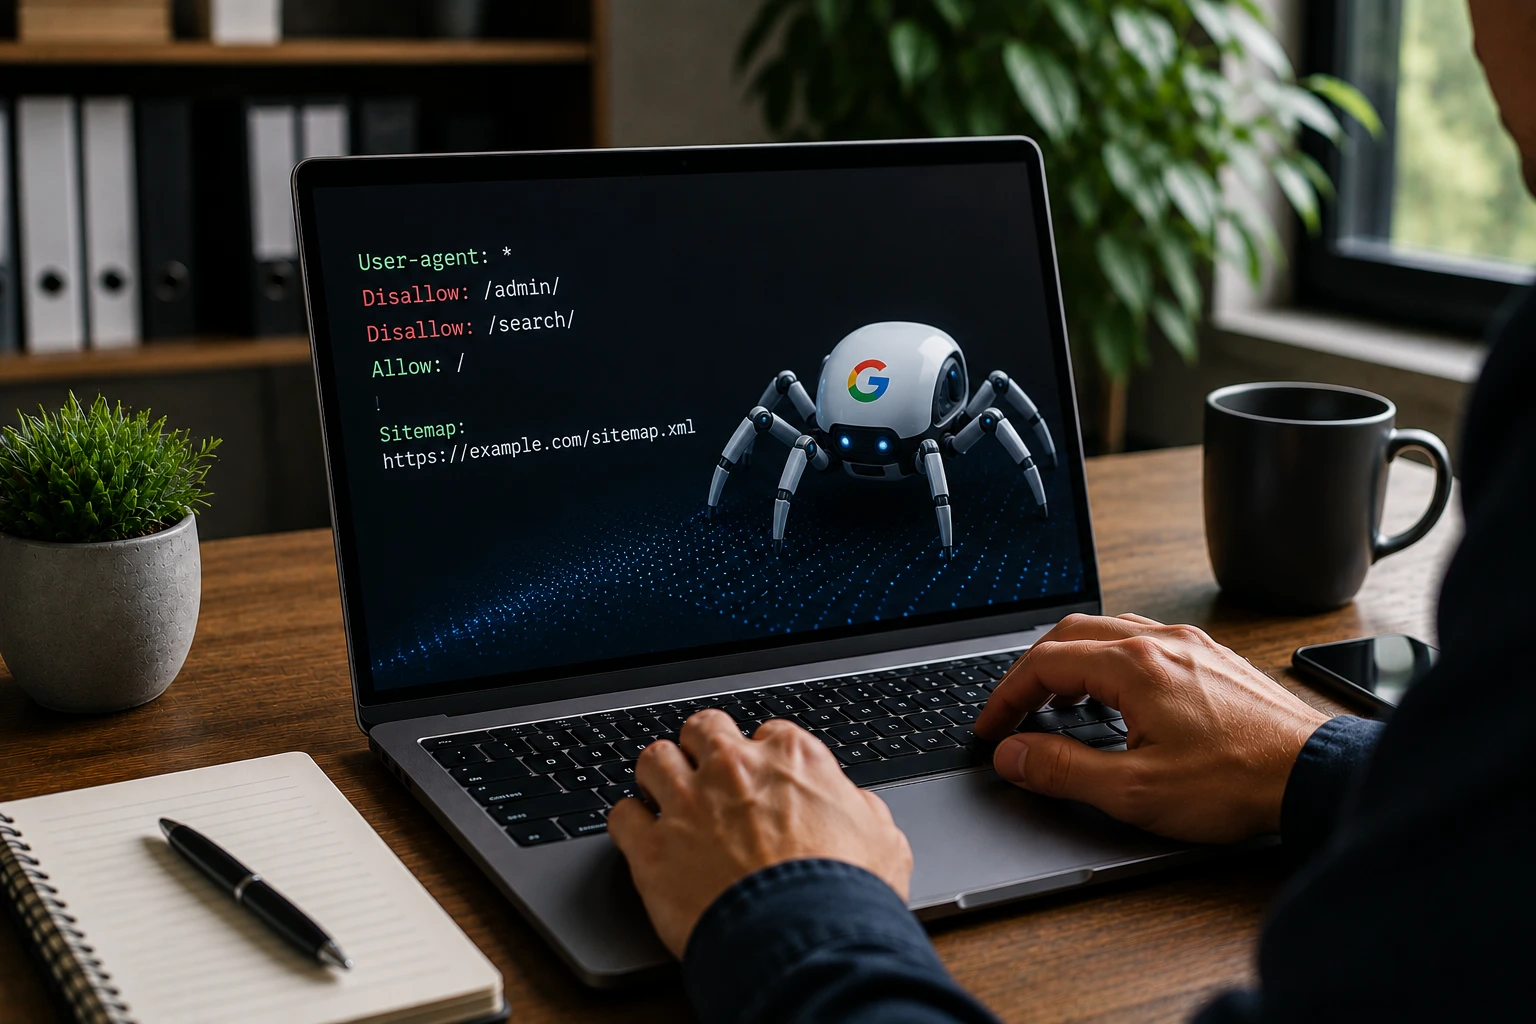
Ketika membahas Technical SEO, ada beberapa file yang terlihat sederhana tetapi memiliki peran penting dalam cara mesin pencari berinteraksi dengan website. Salah satunya adalah robots.txt.
File ini sering dianggap sebagai “file untuk memblokir Google”. Padahal, fungsi robots.txt lebih spesifik dari itu. Robots.txt digunakan untuk memberikan instruksi kepada crawler mengenai bagian tertentu dari website yang boleh atau tidak boleh diakses untuk crawling.
Kesalahan konfigurasi robots.txt juga bisa cukup serius. Bayangkan website sudah memiliki ratusan artikel berkualitas, tetapi crawler justru diblokir dari halaman penting. Akibatnya, mesin pencari dapat mengalami kesulitan mengakses dan memahami konten tersebut.
Lalu, apa itu robots.txt? Apa fungsinya dalam SEO? Bagaimana cara membuat robots.txt yang benar? Apakah robots.txt bisa menghapus halaman dari Google? Apa perbedaannya dengan noindex? Dan bagaimana cara mengecek apakah robots.txt memblokir halaman penting?
Artikel ini membahas robots.txt secara lengkap dan praktis.
Apa Itu Robots.txt?
Robots.txt adalah file teks yang ditempatkan pada root domain untuk memberikan instruksi kepada crawler mengenai URL atau pola URL yang boleh atau tidak boleh di-crawl.
Contohnya:
https://example.com/robots.txt
File ini menggunakan standar Robots Exclusion Protocol.
Crawler seperti Googlebot dapat membaca file tersebut untuk memahami aturan crawling yang diberikan oleh pemilik website.
Contoh sederhana:
User-agent: *
Disallow: /admin/
Artinya, aturan tersebut ditujukan kepada semua user-agent dan meminta crawler untuk tidak melakukan crawling pada URL di bawah /admin/.
Namun, perlu dipahami bahwa robots.txt bukan mekanisme keamanan.
Apa Fungsi Robots.txt dalam SEO?
Fungsi utama robots.txt adalah mengontrol crawling, bukan menentukan ranking.
Robots.txt dapat digunakan untuk membantu mengelola bagian website yang tidak perlu di-crawl.
Contohnya:
- Area administrasi.
- URL tertentu yang tidak penting untuk crawler.
- Resource atau pola URL tertentu yang menghasilkan banyak variasi.
- Internal search result.
- Parameter tertentu dalam kondisi yang memang membutuhkan pengelolaan crawling.
Untuk website besar, robots.txt dapat menjadi bagian dari strategi crawl management.
Namun, jangan menggunakannya untuk memblokir halaman penting yang ingin muncul di Google.
Apakah Robots.txt Wajib untuk Setiap Website?
Tidak.
Website tetap dapat berjalan tanpa robots.txt.
Jika file tersebut tidak tersedia, crawler masih dapat mengakses halaman berdasarkan aturan crawling dan sumber URL yang ditemukan.
Namun, memiliki robots.txt yang valid dapat membantu Anda mengomunikasikan aturan crawling dengan lebih jelas.
Untuk website profesional, file ini biasanya layak diperiksa dan dikelola dengan benar meskipun isinya sangat sederhana.
Contohnya:
User-agent: *
Allow: /

Sitemap: https://example.com/sitemap.xml
Aturan tersebut pada dasarnya tidak memblokir crawling dan sekaligus memberikan lokasi sitemap.
Di Mana Letak Robots.txt?
Robots.txt harus berada di root host yang bersangkutan.
Contohnya:
https://example.com/robots.txt
Bukan:
https://example.com/seo/robots.txt
dan bukan:
https://example.com/blog/robots.txt
Untuk website yang menggunakan subdomain, setiap host dapat memiliki robots.txt sendiri.
Misalnya:
https://example.com/robots.txt
berbeda dengan:
https://blog.example.com/robots.txt
Karena itu, perhatikan struktur domain dan subdomain ketika melakukan audit.
Apa Struktur Dasar Robots.txt?
Robots.txt menggunakan beberapa directive yang umum.
Contohnya:
User-agent: *
Disallow: /admin/
Ada dua bagian penting:
User-agent
Menentukan crawler yang menjadi target aturan.
Disallow
Menentukan path yang tidak ingin di-crawl oleh crawler tersebut.
Anda juga dapat menemukan directive seperti:
Allow
Digunakan dalam kondisi tertentu untuk memberikan pengecualian terhadap aturan Disallow.
Sitemap
Memberikan informasi mengenai lokasi sitemap XML.
Apa Itu User-agent?
User-agent adalah identitas crawler yang menjadi target sebuah aturan.
Contohnya:
User-agent: *Tanda * berarti aturan tersebut berlaku untuk semua user-agent yang mengikuti aturan robots.txt.
Anda juga dapat membuat aturan khusus untuk crawler tertentu.
Misalnya:
User-agent: Googlebot
Disallow: /private/
Namun, jangan membuat aturan spesifik tanpa memahami kebutuhan sebenarnya.
Untuk sebagian besar website, aturan yang sederhana lebih mudah dikelola.
Apa Arti Disallow?
Disallow digunakan untuk menentukan path yang tidak ingin di-crawl oleh crawler yang sesuai.
Contoh:
User-agent: *
Disallow: /admin/
Crawler diminta untuk tidak melakukan crawling terhadap path /admin/.
Contoh lainnya:
User-agent: *
Disallow: /search/
Aturan tersebut dapat digunakan ketika Anda memang tidak ingin crawler mengakses halaman internal search.
Namun, sebelum menggunakan Disallow, pastikan URL tersebut memang tidak perlu di-crawl.
Apa Arti Allow?
Allow dapat digunakan untuk memberikan pengecualian terhadap aturan tertentu.
Contohnya:
User-agent: *
Disallow: /private/
Allow: /private/public-file.html
Dalam situasi seperti ini, aturan dapat digunakan untuk memungkinkan crawler mengakses file tertentu meskipun berada di bawah path yang diblokir.
Namun, penggunaan Allow perlu dipahami bersama aturan Disallow dan cara crawler tertentu memproses aturan tersebut.
Untuk website biasa, jangan membuat konfigurasi kompleks jika tidak diperlukan.
Apa Arti Tanda Bintang?
Tanda * digunakan sebagai wildcard pada konteks tertentu.
Dalam:
User-agent: *artinya aturan ditujukan kepada semua crawler yang mengikuti robots.txt.
Contoh:
Disallow: /private/*memiliki maksud yang berbeda tergantung parser dan pola yang digunakan.
Karena itu, jika aturan robots.txt mulai menggunakan wildcard atau konfigurasi kompleks, lakukan pengujian dengan hati-hati.
Apa Hubungan Robots.txt dengan Sitemap?
Robots.txt dapat mencantumkan lokasi sitemap.
Contohnya:
User-agent: *
Disallow:

Sitemap: https://example.com/sitemap.xml
Ini membantu crawler menemukan lokasi sitemap.
Namun, sitemap dan robots.txt memiliki fungsi berbeda.
Robots.txt → memberikan aturan crawling.
Sitemap → memberikan daftar URL yang ingin ditemukan dan diproses.
Keduanya dapat saling melengkapi.
Apakah Robots.txt Bisa Mencegah Halaman Terindeks?
Ini adalah salah satu hal yang paling sering disalahpahami.
Robots.txt bukan cara yang tepat untuk memastikan sebuah halaman tidak muncul dalam indeks Google.
Jika URL diblokir oleh robots.txt, Google mungkin tidak dapat meng-crawl halaman tersebut. Namun, URL tersebut masih dapat diketahui dari sumber lain, seperti link eksternal.
Dalam kondisi tertentu, URL yang tidak dapat di-crawl masih dapat muncul dalam hasil pencarian tanpa informasi lengkap mengenai halaman tersebut.
Jika tujuan Anda adalah memberi tahu Google agar sebuah halaman tidak diindeks, gunakan mekanisme seperti noindex pada halaman tersebut, dengan syarat crawler dapat mengakses halaman untuk membaca instruksinya.
Jadi:
Robots.txt → kontrol crawling
Noindex → kontrol indexing
Jangan menukar fungsi keduanya.
Apa Perbedaan Robots.txt dan Noindex?
Perbedaannya sangat penting.
| Robots.txt | Noindex |
|---|---|
| Mengatur crawling | Mengatur indexing |
| Berada di root domain | Biasanya berupa meta robots atau HTTP header |
| Memberi instruksi akses crawler | Memberi instruksi agar halaman tidak diindeks |
| Tidak cocok sebagai pengganti noindex | Cocok untuk halaman yang memang tidak ingin diindeks |
| Dapat menghalangi crawler membaca halaman | Membutuhkan crawler mengakses halaman untuk melihat instruksi |
Misalnya Anda memiliki halaman:
/promo-lama/
dan tidak ingin halaman tersebut muncul dalam Google.
Jangan hanya menulis:
Disallow: /promo-lama/jika tujuan utamanya adalah menghapus halaman dari indeks.
Evaluasi penggunaan noindex pada halaman tersebut.
Apakah Robots.txt Merupakan Sistem Keamanan?
Tidak.
Ini sangat penting.
Robots.txt hanyalah file teks yang dapat dibaca siapa pun.
Misalnya Anda menulis:
Disallow: /private-data/Itu bukan berarti /private-data/ menjadi aman.
Orang tetap dapat mencoba membuka:
https://example.com/private-data/
Jika suatu data benar-benar rahasia, jangan mengandalkan robots.txt.
Gunakan:
- Authentication.
- Authorization.
- Access control.
- Server configuration.
- Proteksi aplikasi.
- Permission yang sesuai.
Robots.txt bukan firewall dan bukan password.
Bagaimana Cara Membuat Robots.txt?
Untuk website sederhana, robots.txt dapat dibuat menggunakan text editor biasa.
Buat file bernama:
robots.txt
Kemudian masukkan aturan yang diperlukan.
Contoh paling sederhana:
User-agent: *
Disallow:

Sitemap: https://example.com/sitemap.xml
Setelah itu, file ditempatkan pada root domain.
Kemudian buka:
https://example.com/robots.txt
untuk memastikan file dapat diakses.
Contoh Robots.txt Sederhana untuk Website
Untuk website yang tidak memiliki kebutuhan khusus, konfigurasi sederhana dapat digunakan:
User-agent: *
Disallow:

Sitemap: https://example.com/sitemap.xml
Artinya website tidak memberikan larangan crawling melalui aturan tersebut dan menyediakan lokasi sitemap.
Ini bukan berarti semua URL otomatis akan diindeks.
Google tetap memproses URL berdasarkan sistem pencariannya.
Contoh Memblokir Area Admin
Jika website memiliki area yang memang tidak perlu di-crawl:
User-agent: *
Disallow: /admin/

Sitemap: https://example.com/sitemap.xml
Namun, jika area tersebut benar-benar membutuhkan perlindungan, tetap gunakan authentication.
Jangan menganggap Disallow sebagai proteksi keamanan.
Contoh Memblokir Internal Search
Website dengan fitur pencarian internal dapat menghasilkan banyak URL.
Misalnya:
/search/?q=seo
/search/?q=wordpress
/search/?q=website
Jika halaman tersebut tidak memiliki nilai pencarian dan dapat menghasilkan kombinasi URL dalam jumlah besar, Anda dapat mempertimbangkan pengelolaan crawling terhadap pola tersebut.
Contohnya:
User-agent: *
Disallow: /search/
Namun, lakukan evaluasi terlebih dahulu.
Jangan memblokir URL hanya karena terlihat seperti parameter.
Robots.txt pada WordPress
WordPress dapat menghasilkan robots.txt secara virtual atau dikelola melalui konfigurasi tertentu.
Pada website WordPress modern, Anda mungkin tidak perlu membuat file fisik secara manual jika sistem atau plugin SEO sudah menangani robots.txt.
Namun, tetap penting memahami hasil akhirnya.
Buka:
https://domainanda.com/robots.txt
dan periksa isi yang benar-benar diterima crawler.
Jangan hanya melihat pengaturan di dashboard.
Yang penting adalah output final yang tersedia di website.
Robots.txt dan Plugin SEO
Plugin SEO dapat membantu mengelola berbagai aspek SEO teknis, termasuk sitemap dan dalam beberapa kasus pengaturan robots.txt.
Namun, jangan mengaktifkan beberapa konfigurasi yang saling bertentangan.
Misalnya:
- Plugin A mengatur robots.txt.
- Plugin B mengubah robots.txt.
- Server memiliki aturan tambahan.
- CDN memiliki konfigurasi crawler.
Jika terjadi masalah, Anda harus mengetahui sumber aturan yang sebenarnya.
Gunakan satu konfigurasi yang jelas.
Apakah WordPress Perlu Memblokir wp-admin?
Pada WordPress, Anda mungkin menemukan:
Disallow: /wp-admin/Ini merupakan pola yang umum.
Namun, beberapa resource tertentu di bawah wp-admin dapat dibutuhkan pada konteks tertentu, sehingga konfigurasi yang terlalu agresif perlu dihindari.
Jangan sembarangan memblokir:
- CSS.
- JavaScript.
- Gambar.
- Resource penting.
Jika resource tersebut dibutuhkan untuk memahami atau merender halaman, pemblokiran dapat menyebabkan masalah.
Apakah CSS dan JavaScript Perlu Diblokir?
Pada website modern, jangan sembarangan memblokir CSS atau JavaScript yang dibutuhkan untuk memahami halaman.
Dulu banyak website menggunakan robots.txt untuk memblokir folder resource.
Pendekatan tersebut dapat menimbulkan masalah jika crawler membutuhkan resource tersebut untuk memahami bagaimana halaman ditampilkan.
Contohnya:
Disallow: /css/
Disallow: /js/
Jangan gunakan aturan seperti ini hanya karena Anda ingin “mengurangi crawling”.
Evaluasi terlebih dahulu apakah resource tersebut diperlukan untuk rendering dan pemahaman halaman.
Robots.txt dan JavaScript Website Modern
Website modern dapat menggunakan JavaScript untuk:
- Navigation.
- Content rendering.
- Filter.
- Form.
- Interactive components.
- Dynamic data.
Jika crawler tidak dapat mengakses resource penting, proses rendering dapat terganggu.
Karena itu, Technical SEO dan web development harus saling berkoordinasi.
Developer tidak seharusnya hanya melihat:
“Website berjalan di browser.”
SEO specialist juga tidak cukup hanya melihat:
“Robots.txt tidak error.”
Keduanya harus memastikan halaman penting dapat diakses dan dipahami crawler.
Bagaimana Cara Mengecek Robots.txt?
Langkah paling sederhana adalah membuka:
https://domainanda.com/robots.txt
Periksa:
- Apakah file dapat diakses?
- Apakah formatnya masuk akal?
- Apakah ada
Disallowyang terlalu luas? - Apakah halaman penting terblokir?
- Apakah sitemap tercantum?
- Apakah ada aturan crawler tertentu?
- Apakah konfigurasi sesuai tujuan?
Kemudian gunakan tools SEO atau Search Console untuk memeriksa dampaknya terhadap URL tertentu.
Bagaimana Jika Halaman Terblokir Robots.txt?
Jika halaman penting ternyata terblokir, jangan langsung menghapus semua aturan.
Cari tahu aturan mana yang menyebabkan pemblokiran.
Misalnya:
User-agent: *
Disallow: /blog/
Jika website memiliki artikel di:
/blog/seo/
maka seluruh bagian tersebut dapat terkena aturan.
Jika artikel tersebut ingin diindeks, aturan tersebut perlu ditinjau.
Bagaimana Jika Banyak URL Tidak Terindeks?
Robots.txt mungkin menjadi salah satu penyebab, tetapi jangan langsung menyalahkannya.
Periksa juga:
noindex.- Canonical.
- Sitemap.
- Internal link.
- Duplicate content.
- Server error.
- Kualitas konten.
- Search intent.
- Status HTTP.
Misalnya Google Search Console menunjukkan:
Discovered – currently not indexed
belum tentu penyebabnya robots.txt.
Jika halaman bahkan belum di-crawl, barulah akses crawler menjadi salah satu hal yang perlu diperiksa.
Robots.txt dan Crawl Budget
Untuk website besar, robots.txt dapat digunakan sebagai bagian dari strategi pengelolaan crawl resources.
Misalnya website menghasilkan jutaan URL melalui:
- Filter.
- Parameter.
- Internal search.
- Session URL.
- Kalender.
- Sorting.
Tidak semua URL tersebut perlu diproses crawler.
Dengan pengelolaan yang tepat, crawler dapat lebih fokus pada URL yang memiliki nilai.
Namun, jangan menggunakan robots.txt secara agresif.
Tujuan crawl management bukan memblokir sebanyak mungkin URL.
Tujuannya adalah mengurangi crawling yang tidak perlu sambil tetap membuka akses terhadap halaman penting.
Robots.txt pada Website E-Commerce
E-commerce sering memiliki struktur URL yang kompleks.
Misalnya:
/produk/sepatu/
kemudian memiliki filter:
/produk/sepatu/?warna=hitam
/produk/sepatu/?ukuran=42
/produk/sepatu/?sort=price
Jika setiap kombinasi menghasilkan URL baru, jumlah URL dapat berkembang sangat besar.
Dalam situasi tertentu, crawling terhadap pola URL tertentu perlu dikelola.
Namun, strategi harus disesuaikan dengan arsitektur website.
Jangan memblokir seluruh kategori produk hanya karena beberapa parameter tidak dibutuhkan.
Robots.txt dan Parameter URL
Parameter URL perlu diperhatikan terutama pada website besar.
Contohnya:
?sort=asc
?sort=desc
?filter=red
?page=2
Tidak semua parameter harus diperlakukan sama.
Beberapa parameter dapat menghasilkan konten yang penting.
Yang lain mungkin hanya menghasilkan variasi yang tidak perlu.
Karena itu, lakukan audit berdasarkan fungsi parameter, bukan berdasarkan tampilannya saja.
Apakah Robots.txt Mempengaruhi Ranking?
Robots.txt bukan faktor ranking langsung.
Namun, konfigurasi robots.txt yang salah dapat berdampak tidak langsung pada SEO.
Misalnya Anda memblokir:
/blog/
Padahal semua artikel penting berada di dalam direktori tersebut.
Google kemudian kesulitan mengakses halaman tersebut.
Akibatnya, halaman dapat mengalami masalah dalam crawling dan indexing.
Jadi, robots.txt bukan “faktor ranking”, tetapi kesalahan robots.txt dapat menyebabkan masalah SEO yang serius.
Kesalahan Robots.txt yang Sering Terjadi
Memblokir Seluruh Website
Kesalahan paling berbahaya adalah konfigurasi seperti:
User-agent: *
Disallow: /
Aturan tersebut meminta crawler untuk tidak melakukan crawling pada seluruh website.
Jika website production menggunakan konfigurasi seperti ini tanpa alasan yang tepat, halaman penting dapat mengalami masalah discovery dan crawling.
Memblokir Direktori Konten
Misalnya:
Disallow: /blog/padahal blog merupakan sumber utama organic traffic.
Memblokir CSS dan JavaScript
Resource penting dapat ikut terhalang.
Menggunakan Robots.txt sebagai Keamanan
Data rahasia tetap dapat diakses jika tidak dilindungi dengan authentication.
Menggunakan Robots.txt untuk Noindex
Fungsi robots.txt dan noindex berbeda.
Tidak Memeriksa Setelah Migrasi
Website yang dipindahkan dari staging ke production dapat membawa konfigurasi robots.txt yang salah.
Lupa Membuka Website Setelah Development
Website staging mungkin menggunakan:
Disallow: /Ini masuk akal untuk staging yang tidak ingin di-crawl.
Namun, konfigurasi tersebut harus diperiksa ketika website dipindahkan ke production.
Robots.txt untuk Website Staging
Pada website development atau staging, Anda memang mungkin tidak ingin crawler mengakses website.
Contohnya:
User-agent: *
Disallow: /
Namun, jangan biarkan konfigurasi tersebut terbawa ke production.
Ini merupakan salah satu kesalahan deployment yang cukup serius.
Setelah website live, periksa kembali:
https://domainanda.com/robots.txt
Pastikan aturan sesuai dengan lingkungan production.
Apakah Robots.txt Perlu Diperbarui?
Tidak perlu diperbarui setiap hari.
Perbarui ketika:
- Struktur website berubah.
- Ada direktori baru.
- Strategi crawling berubah.
- Website mengalami migrasi.
- Parameter URL berubah.
- Ada kebutuhan teknis baru.
Yang paling penting bukan frekuensi update, tetapi ketepatan aturan.
Hubungan Robots.txt dengan Technical SEO
Robots.txt merupakan salah satu komponen Technical SEO bersama:
- Crawling.
- Indexing.
- XML Sitemap.
- Canonical.
- URL structure.
- Internal linking.
- Structured data.
- Core Web Vitals.
- Mobile SEO.
Semua komponen tersebut harus bekerja secara konsisten.
Misalnya:
Sitemap memberitahu Google mengenai URL penting.
Robots.txt tidak boleh memblokir URL penting tersebut.
Canonical harus menunjuk ke versi URL yang benar.
Noindex harus digunakan pada halaman yang memang tidak ingin diindeks.
Jika keempatnya memberikan sinyal yang bertentangan, proses SEO menjadi lebih rumit.
Checklist Robots.txt
Gunakan checklist berikut ketika melakukan audit:
-
/robots.txtdapat diakses. - File berada di root domain.
- Tidak ada
Disallow: /yang tidak disengaja. - Halaman penting tidak terblokir.
- Blog tidak terblokir tanpa alasan.
- Halaman layanan tidak terblokir.
- Resource penting tidak terblokir.
- CSS tidak diblokir tanpa alasan.
- JavaScript penting tidak diblokir tanpa alasan.
- Sitemap tercantum.
- URL admin dikelola dengan tepat.
- Internal search dievaluasi.
- Parameter URL dievaluasi.
- Robots.txt staging tidak terbawa ke production.
- Robots.txt tidak digunakan sebagai sistem keamanan.
-
noindexdigunakan untuk kebutuhan indexing. - Konfigurasi diperiksa setelah migrasi.
- Aturan crawler tidak saling bertentangan.
- Perubahan robots.txt diuji sebelum diterapkan.
Kesimpulan
Jadi, apa itu robots.txt?
Robots.txt adalah file yang digunakan untuk memberikan instruksi kepada crawler mengenai bagian tertentu dari website yang boleh atau tidak boleh di-crawl.
Dalam SEO, robots.txt terutama berkaitan dengan crawl management, bukan ranking secara langsung.
Robots.txt dapat membantu website mengelola crawling terhadap URL yang tidak perlu diproses, terutama pada website besar yang memiliki banyak parameter, filter, halaman internal search, atau struktur URL yang kompleks.
Namun, ada satu prinsip yang harus selalu diingat:
Robots.txt mengontrol crawling, bukan indexing.
Jika Anda ingin halaman tidak masuk indeks, jangan otomatis menggunakan Disallow. Evaluasi penggunaan noindex pada halaman tersebut agar Google dapat membaca instruksi indexing-nya.
Selain itu, robots.txt bukan sistem keamanan. Jangan pernah menyimpan informasi rahasia hanya dengan mengandalkan file ini.
Untuk website production, konfigurasi robots.txt sebaiknya sederhana, jelas, dan tidak memblokir halaman atau resource penting secara tidak sengaja.
Struktur Technical SEO yang sehat dapat dibangun dengan hubungan:
Crawling → Robots.txt → Sitemap → Internal Link → Canonical → Indexing
Semua sinyal tersebut harus konsisten.
Dan yang paling penting, jangan menganggap robots.txt semakin banyak memblokir berarti semakin baik.
Robots.txt yang baik bukan yang paling ketat, tetapi yang memberikan instruksi crawling secara tepat tanpa menghalangi mesin pencari mengakses halaman yang memang penting.
Dengan konfigurasi yang benar, robots.txt dapat menjadi bagian penting dari fondasi Technical SEO dan membantu website mengelola bagaimana crawler menjelajahi struktur website secara lebih efisien.