
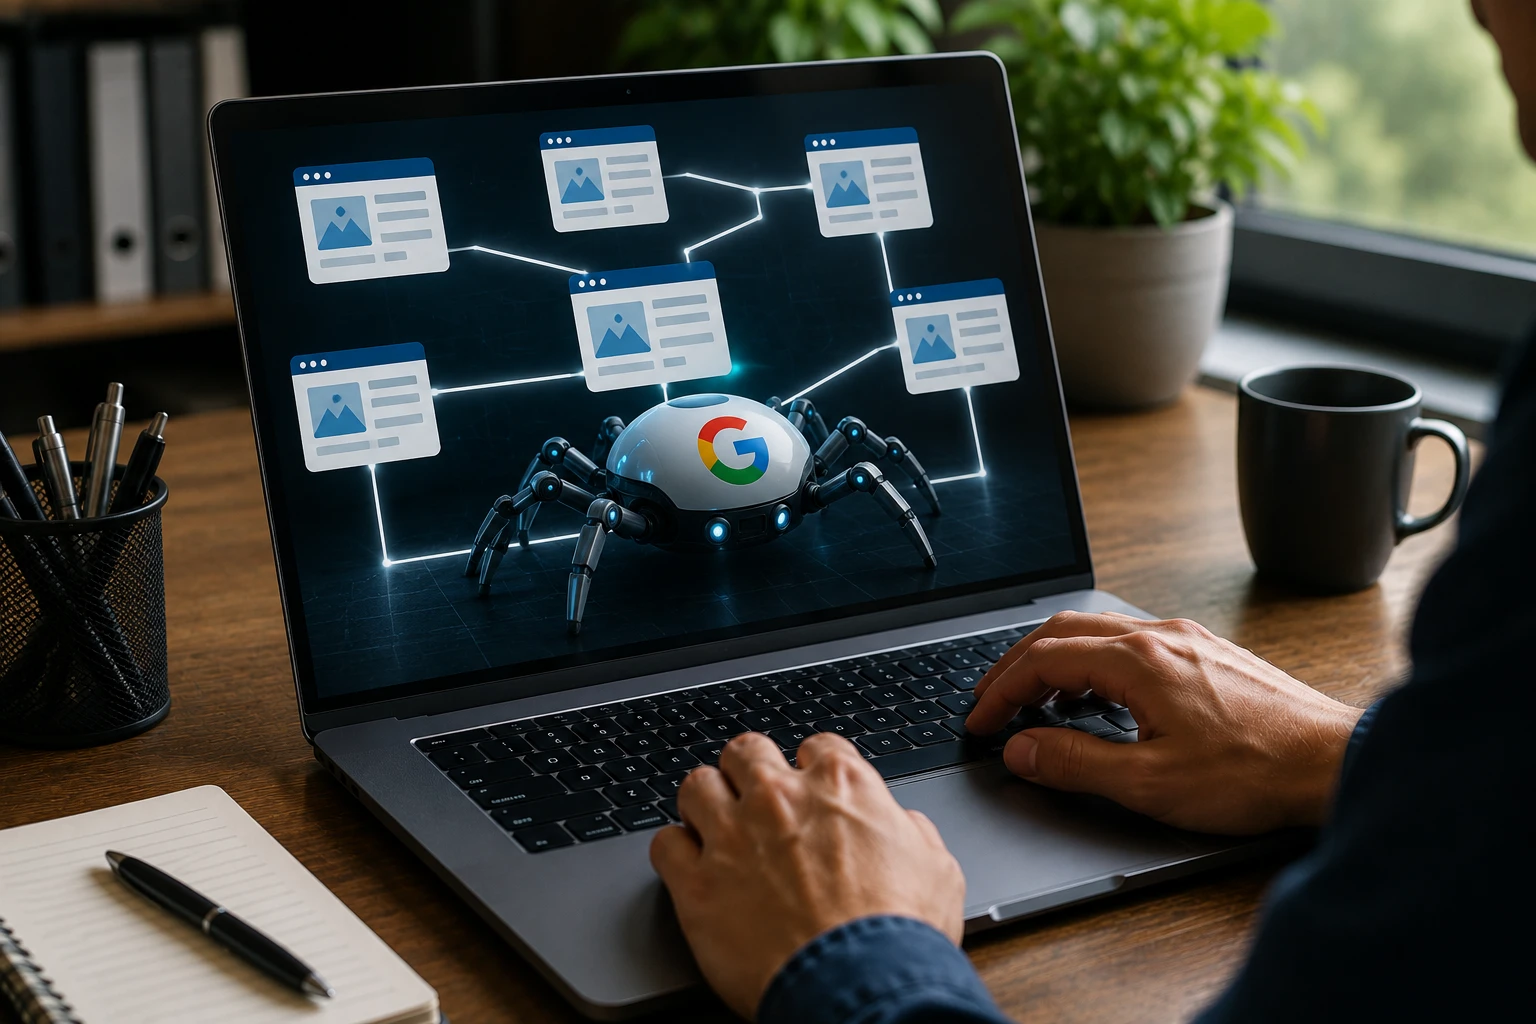
Ketika sebuah halaman website muncul di hasil pencarian Google, ada proses yang terjadi jauh sebelum pengguna melihatnya. Google harus menemukan URL tersebut, mengaksesnya, membaca berbagai resource, memahami isi halaman, lalu menentukan apakah halaman tersebut layak diproses lebih lanjut untuk ditampilkan dalam hasil pencarian.
Proses ketika mesin pencari menemukan dan mengakses halaman website ini dikenal sebagai crawling.
Bagi pemilik website, memahami crawling penting karena halaman yang tidak dapat ditemukan atau diakses crawler dapat mengalami masalah dalam proses indexing dan akhirnya tidak muncul di hasil pencarian.
Lalu, apa itu crawling dalam SEO? Bagaimana Google menjelajahi website? Apa itu Googlebot? Apa hubungan crawling dengan indexing? Mengapa halaman website tidak selalu langsung di-crawl? Dan bagaimana cara memastikan website lebih mudah dijelajahi mesin pencari?
Artikel ini membahas crawling secara lengkap dengan bahasa sederhana dan praktis.
Apa Itu Crawling?
Crawling adalah proses ketika mesin pencari menemukan, mengakses, dan memproses halaman atau resource di website menggunakan program otomatis yang disebut crawler.
Crawler Google dikenal sebagai Googlebot.
Secara sederhana, prosesnya dapat dibayangkan seperti ini:
Google menemukan URL → Googlebot mengakses URL → Google membaca halaman → Google memproses informasi → halaman dapat dipertimbangkan untuk indexing
Namun, proses sebenarnya jauh lebih kompleks.
Google tidak sekadar membuka halaman seperti manusia membuka browser. Sistem crawling harus mengelola miliaran URL, menentukan halaman mana yang perlu dikunjungi, kapan harus dikunjungi kembali, dan resource mana yang perlu diproses.
Apa Itu Googlebot?
Googlebot adalah nama umum untuk crawler yang digunakan Google untuk menjelajahi web.
Google menggunakan berbagai jenis Googlebot untuk kebutuhan crawling yang berbeda.
Secara umum, Anda dapat menemukan istilah seperti:
- Googlebot Smartphone.
- Googlebot Desktop.
- Googlebot untuk jenis konten atau kebutuhan tertentu.
Untuk website modern, Googlebot Smartphone sangat penting karena Google menggunakan mobile-first indexing.
Artinya, versi mobile halaman menjadi versi utama yang digunakan Google untuk proses indexing dan evaluasi konten.
Karena itu, website tidak seharusnya hanya bagus di desktop.
Website juga harus memberikan pengalaman dan konten yang baik pada perangkat mobile.
Bagaimana Cara Google Menemukan URL?
Google dapat menemukan URL melalui berbagai sumber.
Salah satunya adalah link.
Misalnya:
Website A → Website B → Halaman C
Ketika Google menemukan link menuju halaman tertentu, URL tersebut dapat menjadi kandidat untuk dikunjungi.
Selain link, sitemap XML juga dapat membantu memberikan daftar URL yang ingin Anda sampaikan kepada mesin pencari.
Namun, penting dipahami:
URL yang ditemukan belum tentu langsung di-crawl.
Google tetap menentukan kapan dan bagaimana URL tersebut diproses.
Apa Perbedaan Crawling dan Indexing?
Crawling dan indexing sering dianggap sama.
Padahal, keduanya berbeda.
Crawling
Crawling adalah proses menemukan dan mengakses halaman.
Indexing
Indexing adalah proses memproses dan menyimpan informasi mengenai halaman sehingga dapat dipertimbangkan untuk ditampilkan dalam hasil pencarian.
Sederhananya:
Crawling = Google menemukan dan mengunjungi
Indexing = Google memproses dan memasukkan informasi ke sistem pencarian
Jadi, sebuah halaman bisa saja:
- Sudah ditemukan.
- Sudah di-crawl.
- Tetapi belum tentu diindeks.
Hal tersebut merupakan salah satu alasan mengapa URL yang dapat diakses belum tentu langsung muncul di Google.
Apakah Semua Halaman yang Di-Crawl Akan Diindeks?
Tidak.
Google dapat meng-crawl sebuah halaman tetapi tidak memasukkannya ke dalam indeks.
Ada banyak alasan yang dapat memengaruhi keputusan tersebut.
Misalnya:
- Konten sangat mirip dengan halaman lain.
- Konten dianggap tidak memberikan nilai yang cukup.
- Halaman memiliki masalah teknis.
- Ada instruksi tertentu yang memengaruhi indexing.
- Google belum menentukan halaman tersebut layak dimasukkan ke indeks.
- Kualitas halaman tidak memenuhi kebutuhan sistem pencarian.
Karena itu, jangan menggunakan asumsi:
“Kalau sudah di-crawl, pasti terindeks.”
Crawling dan indexing merupakan dua proses berbeda.
Apa Itu Crawl Budget?
Crawl budget adalah istilah yang digunakan untuk menggambarkan sumber daya dan perhatian yang dialokasikan mesin pencari untuk crawling sebuah website.
Untuk website kecil, crawl budget biasanya bukan sesuatu yang perlu terlalu dikhawatirkan.
Namun, pada website dengan:
- Ribuan halaman.
- Ratusan ribu URL.
- Jutaan URL.
- Parameter URL dalam jumlah besar.
- Infinite spaces.
- Banyak halaman duplikat.
pengelolaan crawling menjadi lebih penting.
Masalahnya bukan sekadar:
“Bagaimana membuat Google crawl lebih banyak?”
Pertanyaan yang lebih tepat adalah:
“Bagaimana memastikan crawler menggunakan sumber dayanya untuk halaman yang memang penting?”
Apa yang Dapat Menghabiskan Crawl Resources?
Beberapa kondisi dapat membuat crawler menghabiskan waktu pada URL yang kurang bernilai.
Contohnya:
- URL parameter dalam jumlah besar.
- Filter dan sorting yang menghasilkan banyak URL.
- Halaman duplikat.
- Kalender dengan URL tak terbatas.
- Search result internal yang dapat menghasilkan banyak kombinasi URL.
- Redirect chain.
- Broken links.
- Soft 404.
- Halaman dengan konten sangat tipis.
- URL yang sebenarnya tidak perlu di-crawl.
Untuk website besar, struktur URL perlu dirancang dengan baik sejak awal.
Apakah Crawl Budget Penting untuk Website Kecil?
Biasanya tidak perlu menjadi fokus utama.
Jika website hanya memiliki puluhan, ratusan, atau beberapa ribu halaman yang terstruktur dengan baik, masalah crawling budget biasanya bukan persoalan utama.
Jangan sampai terlalu fokus pada crawl budget tetapi mengabaikan:
- Kualitas konten.
- Search intent.
- Internal linking.
- Technical SEO.
- Indexing.
- User experience.
Untuk website kecil, pastikan saja crawler dapat mengakses halaman penting dan tidak terjebak pada struktur URL yang bermasalah.
Apa yang Menghambat Crawling?
Ada berbagai hal yang dapat menghambat Googlebot mengakses halaman.
Robots.txt
File robots.txt dapat memberikan instruksi kepada crawler mengenai URL atau pola URL yang tidak ingin di-crawl.
Jika salah konfigurasi, file ini dapat menghambat crawler mengakses halaman penting.
Server Error
Jika server sering memberikan:
- 5xx error.
- Timeout.
- Connection error.
Googlebot dapat mengalami kesulitan mengakses halaman.
Internal Link yang Buruk
Jika halaman penting tidak memiliki internal link yang jelas, crawler dapat memiliki lebih sedikit jalur untuk menemukannya.
Struktur Website Terlalu Dalam
Jika halaman penting terlalu jauh dari halaman lain dan tidak memiliki navigasi yang baik, struktur tersebut perlu dievaluasi.
Redirect Berlebihan
Redirect chain yang panjang dapat membuat proses crawling menjadi kurang efisien.
URL yang Tidak Terbatas
Filter, parameter, atau fitur tertentu dapat menghasilkan jumlah URL yang sangat besar.
Apa Itu Robots.txt?
Robots.txt adalah file yang digunakan untuk memberikan instruksi kepada crawler mengenai bagian tertentu dari website yang boleh atau tidak boleh di-crawl.
Lokasinya biasanya:
/robots.txt
Contoh sederhana:
User-agent: *
Disallow: /admin/
Artinya instruksi tersebut ditujukan kepada semua user-agent dan melarang crawling pada pola /admin/.
Namun, robots.txt perlu digunakan dengan hati-hati.
Jangan memblokir direktori yang sebenarnya berisi resource atau halaman yang dibutuhkan Google untuk memahami website.
Apakah Robots.txt Bisa Mencegah Indexing?
Ini bagian yang sangat penting.
Robots.txt terutama mengontrol crawling, bukan merupakan mekanisme utama untuk mengontrol indexing.
Jika sebuah URL diblokir oleh robots.txt, Google mungkin tidak dapat mengakses kontennya untuk memahami halaman tersebut.
Namun, URL yang diblokir masih dapat diketahui dari sumber lain dan dalam kondisi tertentu tetap dapat muncul di sistem pencarian tanpa isi halaman dapat di-crawl.
Jika tujuan Anda adalah mengontrol apakah sebuah halaman boleh masuk indeks, gunakan mekanisme yang sesuai, seperti noindex, dengan catatan crawler harus dapat mengakses halaman tersebut untuk membaca instruksi tersebut.
Jadi jangan menggunakan:
Disallow
sebagai pengganti:
noindex
Keduanya memiliki fungsi berbeda.
Apa Itu Noindex?
Noindex adalah instruksi yang memberi tahu mesin pencari bahwa sebuah halaman tidak ingin dimasukkan ke dalam indeks pencarian.
Contohnya dapat menggunakan meta robots:
<meta name="robots" content="noindex">Perbedaannya sederhana:
robots.txt → mengatur crawling
noindex → mengatur indexing
Keduanya tidak boleh dianggap sebagai fitur yang sama.
Apakah Internal Link Membantu Crawling?
Ya.
Internal link dapat memberikan jalur bagi crawler untuk berpindah dari satu halaman ke halaman lain.
Misalnya:
Homepage → Kategori → Artikel → Artikel terkait
Struktur seperti ini membantu menciptakan jaringan internal.
Internal link juga membantu pengguna menemukan halaman terkait.
Karena itu, internal linking memiliki manfaat ganda:
User Experience + Search Engine Discovery
Namun, jangan membuat link secara berlebihan.
Prioritaskan hubungan yang memang relevan.
Apa Peran Sitemap XML dalam Crawling?
XML sitemap adalah file yang berisi daftar URL yang ingin Anda sampaikan kepada mesin pencari.
Contohnya:
/sitemap.xml
Sitemap dapat membantu Google menemukan URL yang penting, terutama pada website besar atau website dengan struktur yang kompleks.
Namun, sitemap bukan perintah yang memaksa Google meng-crawl atau mengindeks semua URL.
Anggap sitemap sebagai:
daftar URL yang Anda rekomendasikan untuk ditemukan dan diproses.
Google tetap menentukan apakah dan kapan URL tersebut akan di-crawl.
Apakah Sitemap Menjamin Indexing?
Tidak.
Mengirim sitemap tidak berarti:
“Semua URL pasti masuk Google.”
Sitemap hanya membantu discovery.
Setelah URL ditemukan, Google tetap mengevaluasi halaman tersebut.
Karena itu, jika sitemap berisi ribuan URL yang:
- Duplikat.
- Redirect.
-
- Noindex.
- Tidak penting.
kualitas sitemap menjadi kurang baik.
Idealnya sitemap berisi URL yang memang ingin Anda tampilkan dalam pencarian dan dapat diakses dengan baik.
Bagaimana Google Mengakses Website Modern?
Website modern tidak selalu berupa HTML sederhana.
Banyak website menggunakan:
- JavaScript.
- React.
- Vue.
- Next.js.
- AJAX.
- Dynamic rendering.
- Client-side rendering.
Google dapat memproses JavaScript, tetapi rendering JavaScript merupakan proses tambahan dan dapat memiliki kompleksitas tersendiri.
Karena itu, website modern perlu memastikan konten penting tetap dapat ditemukan dan diproses dengan baik.
Apakah JavaScript Bisa Menghambat Crawling?
JavaScript tidak otomatis buruk untuk SEO.
Masalah dapat muncul ketika konten penting hanya tersedia setelah proses JavaScript tertentu yang sulit atau gagal dijalankan.
Contohnya:
Halaman HTML awal hampir kosong.
Kemudian seluruh konten baru dimunculkan melalui JavaScript.
Jika implementasinya bermasalah, mesin pencari dapat mengalami kesulitan memahami konten tersebut.
Karena itu, developer perlu memastikan:
- Konten utama dapat di-render.
- Link penting dapat ditemukan.
- Navigation dapat diproses.
- Tidak ada error JavaScript kritis.
- Resource penting dapat dimuat.
Crawling pada Website React dan Next.js
Website berbasis React dapat dioptimalkan untuk SEO.
Namun, arsitektur rendering perlu diperhatikan.
Beberapa pendekatan yang umum digunakan adalah:
- Server-Side Rendering.
- Static Site Generation.
- Pre-rendering.
- Client-Side Rendering.
Untuk halaman yang sangat bergantung pada SEO, rendering yang menghasilkan HTML yang dapat diproses dengan baik sejak awal sering kali lebih mudah untuk memastikan konten tersedia.
Framework seperti Next.js menyediakan berbagai pendekatan rendering untuk kebutuhan tersebut.
Namun, pemilihan arsitektur harus mengikuti kebutuhan aplikasi, bukan hanya karena alasan SEO.
Apa Itu Crawlability?
Crawlability adalah tingkat kemudahan sebuah website untuk dijelajahi oleh crawler mesin pencari.
Website dengan crawlability yang baik memiliki:
- Struktur URL yang jelas.
- Internal linking yang baik.
- Sitemap yang benar.
- Robots.txt yang tepat.
- Server yang stabil.
- Sedikit broken link.
- Redirect yang terkontrol.
- Konten yang dapat diakses crawler.
Crawlability merupakan salah satu bagian penting dari Technical SEO.
Bagaimana Cara Memperbaiki Crawlability?
Gunakan Struktur Website yang Jelas
Buat struktur:
Homepage → Kategori → Subkategori → Konten
jika memang sesuai dengan kebutuhan website.
Gunakan Internal Link
Hubungkan halaman yang relevan.
Pastikan Sitemap Benar
Masukkan URL penting dan hindari URL yang tidak seharusnya ada dalam sitemap.
Periksa Robots.txt
Pastikan halaman penting tidak terblokir secara tidak sengaja.
Perbaiki Broken Link
Jangan biarkan banyak link menuju halaman yang sudah tidak tersedia.
Kurangi Redirect Chain
Jika memungkinkan, arahkan URL langsung ke URL final.
Pastikan Server Stabil
Crawler membutuhkan server yang dapat merespons permintaan dengan baik.
Apa Itu Crawl Error?
Crawl error adalah kondisi ketika crawler mengalami masalah ketika mencoba mengakses URL atau resource.
Contohnya:
- Server error.
- DNS error.
- Timeout.
- URL tidak tersedia.
- Masalah koneksi.
- Resource gagal dimuat.
Google Search Console dapat membantu pemilik website menemukan berbagai masalah terkait crawling.
Namun, tidak semua error yang muncul harus dianggap sebagai masalah besar.
Prioritaskan error yang:
- Terjadi pada halaman penting.
- Terjadi dalam jumlah besar.
- Menghambat akses crawler.
- Menyebabkan pengalaman pengguna buruk.
Bagaimana Cara Mengecek Crawling Website?
Beberapa tools dapat digunakan.
Google Search Console
Search Console dapat memberikan berbagai informasi mengenai performa dan kondisi website di Google, termasuk laporan yang berkaitan dengan crawling dan indexing.
URL Inspection
Fitur URL Inspection dapat digunakan untuk memeriksa status URL tertentu di Google.
Anda dapat mengetahui apakah Google mengetahui URL tersebut dan informasi terkait proses indexing yang tersedia.
Server Log
Untuk website besar, server log analysis dapat memberikan informasi yang lebih teknis mengenai bagaimana crawler mengakses server.
Anda dapat melihat:
- URL yang diminta.
- User-agent.
- Status code.
- Waktu permintaan.
- Frekuensi crawling.
Data log sangat berguna untuk website dengan skala besar.
Apa Itu Crawl Stats?
Google Search Console menyediakan laporan Crawl Stats pada properti tertentu.
Laporan ini dapat memberikan gambaran mengenai aktivitas crawling Googlebot pada website.
Data tersebut dapat membantu developer memahami:
- Jumlah request.
- Respons server.
- Waktu download.
- Jenis file yang di-crawl.
- Aktivitas crawler.
Untuk website besar, data ini dapat membantu menemukan pola atau masalah teknis.
Apakah Google Harus Crawl Semua URL?
Tidak.
Justru, website yang sehat tidak selalu menginginkan Google menghabiskan sumber daya untuk setiap URL yang dapat dihasilkan.
Contohnya website e-commerce dapat memiliki kombinasi:
- Produk.
- Kategori.
- Filter.
- Sorting.
- Parameter.
- Search internal.
Jika setiap kombinasi menghasilkan URL unik, jumlah URL dapat meningkat sangat besar.
Yang lebih penting adalah memastikan URL yang bernilai untuk pengguna dan pencarian dapat ditemukan dengan baik.
Crawling pada Website E-Commerce
E-commerce merupakan salah satu contoh website yang memiliki tantangan crawling cukup besar.
Misalnya sebuah kategori memiliki filter:
- Warna.
- Ukuran.
- Harga.
- Brand.
- Rating.
Kombinasi filter dapat menghasilkan banyak URL.
Jika tidak dikelola dengan baik, crawler dapat menghabiskan banyak waktu pada URL yang sebenarnya tidak penting.
Karena itu, arsitektur URL dan sistem filtering harus dirancang dengan mempertimbangkan SEO.
Crawling dan Parameter URL
Parameter seperti:
?sort=price
atau:
?color=red
dapat menghasilkan variasi URL.
Tidak semua variasi tersebut perlu menjadi halaman yang diindeks.
Website perlu menentukan:
- URL mana yang penting.
- URL mana yang hanya untuk UX.
- URL mana yang perlu canonical.
- URL mana yang tidak perlu diindeks.
- URL mana yang tidak perlu di-crawl secara agresif.
Strateginya harus disesuaikan dengan struktur website.
Apakah 404 Menghambat Crawling?
Halaman 404 sendiri bukan masalah otomatis.
Internet secara alami memiliki URL yang sudah tidak tersedia.
Masalah muncul jika website memiliki banyak internal link yang terus-menerus mengarah ke URL 404.
Contohnya:
Artikel A → URL lama → 404
Jika link tersebut seharusnya mengarah ke halaman baru, perbarui internal link.
Untuk halaman yang benar-benar sudah tidak tersedia dan memang tidak memiliki pengganti, status 404 dapat menjadi respons yang sesuai.
Bagaimana dengan Redirect 301?
Redirect 301 digunakan ketika sebuah URL dipindahkan secara permanen ke URL lain.
Misalnya:
URL lama → URL baru
Redirect dapat membantu pengguna dan crawler menemukan lokasi baru halaman.
Namun, jangan membuat rantai seperti:
A → B → C → D
Jika memungkinkan, arahkan:
A → D
secara langsung.
Hal tersebut membuat struktur redirect lebih sederhana.
Apakah Kecepatan Website Memengaruhi Crawling?
Performa server dan kecepatan respons dapat memengaruhi kemampuan crawler mengakses website secara efisien.
Jika server sering lambat atau error, Googlebot dapat mengalami masalah dalam melakukan request.
Namun, jangan menyamakan:
Core Web Vitals
dengan:
Crawlability
Keduanya berkaitan dengan kualitas teknis website tetapi mengukur hal yang berbeda.
Core Web Vitals lebih berfokus pada pengalaman pengguna.
Crawlability lebih berfokus pada kemampuan crawler menemukan dan mengakses resource.
Crawling dan Mobile-First Indexing
Google menggunakan mobile-first indexing, sehingga versi mobile website sangat penting.
Pastikan versi mobile memiliki:
- Konten utama yang sama.
- Structured data yang relevan.
- Link internal yang dapat diakses.
- Metadata yang sesuai.
- Pengalaman pengguna yang baik.
Jangan membuat versi mobile yang jauh lebih sedikit kontennya dibandingkan desktop jika konten tersebut penting untuk pencarian.
Kesalahan Crawling yang Sering Terjadi
Memblokir Seluruh Website
Kesalahan konfigurasi robots.txt dapat menyebabkan crawler tidak dapat mengakses halaman penting.
Memblokir CSS atau JavaScript Penting
Resource yang diperlukan untuk memahami halaman sebaiknya tidak diblokir tanpa alasan.
Sitemap Berisi URL Bermasalah
Jangan memasukkan URL 404, redirect, atau noindex sebagai URL utama dalam sitemap.
Internal Link Menuju URL Lama
Perbarui link menuju URL final jika memungkinkan.
Terlalu Banyak Parameter
Kelola parameter dan filter agar tidak menghasilkan URL tidak terbatas.
Mengabaikan Server Error
Error 5xx berulang dapat menjadi masalah serius bagi crawlability.
Menganggap Crawled = Indexed
Ini adalah salah satu kesalahpahaman paling umum.
Crawling dan indexing merupakan proses berbeda.
Bagaimana Cara Membuat Website Lebih Mudah Di-Crawl?
Gunakan prinsip berikut:
Struktur jelas → Internal link → Sitemap → Robots.txt tepat → Server stabil → URL bersih
Pastikan crawler dapat menemukan halaman penting melalui beberapa jalur yang masuk akal.
Jangan membuat website yang seluruh struktur navigasinya bergantung pada satu halaman atau satu fitur JavaScript.
Checklist Crawlability
Gunakan checklist berikut untuk audit awal:
- Googlebot dapat mengakses website.
- Robots.txt tidak memblokir halaman penting.
- Sitemap XML tersedia.
- Sitemap hanya berisi URL yang relevan.
- Internal linking berjalan dengan baik.
- Tidak banyak broken internal link.
- Tidak ada redirect chain berlebihan.
- Server stabil.
- Error 5xx terkendali.
- URL tidak menghasilkan kombinasi tidak terbatas.
- Konten penting dapat dirender.
- JavaScript tidak menghalangi konten utama.
- Versi mobile memiliki konten penting.
- Halaman penting tidak menjadi orphan page.
- Status HTTP setiap halaman sesuai.
- Crawl Stats diperiksa jika diperlukan.
- URL penting dapat diperiksa melalui Search Console.
Hubungan Crawling dengan Technical SEO
Crawling merupakan salah satu bagian penting dari Technical SEO.
Secara sederhana, prosesnya dapat dipahami seperti ini:
Crawl → Render → Understand → Index → Rank
Namun, proses pencarian sebenarnya jauh lebih kompleks daripada urutan sederhana tersebut.
Crawling hanya merupakan salah satu tahap.
Setelah halaman ditemukan dan diproses, masih ada proses lain yang menentukan bagaimana halaman tersebut diperlakukan dalam sistem pencarian.
Karena itu, memperbaiki crawling tidak otomatis membuat ranking meningkat.
Yang perlu dilakukan adalah membangun fondasi teknis yang sehat secara keseluruhan.
Kesimpulan
Jadi, apa itu crawling dalam SEO?
Crawling adalah proses ketika mesin pencari, seperti Google melalui Googlebot, menemukan dan mengakses halaman serta resource di website untuk diproses lebih lanjut.
Crawling merupakan bagian penting dari perjalanan sebuah halaman menuju hasil pencarian, tetapi crawling tidak sama dengan indexing.
Sebuah halaman dapat ditemukan dan di-crawl tetapi belum tentu masuk indeks.
Untuk membantu website memiliki crawlability yang baik, perhatikan beberapa hal penting seperti:
Robots.txt → Internal Link → Sitemap XML → Struktur URL → Server → Redirect → JavaScript → Mobile → Status HTTP
Website kecil biasanya tidak perlu terlalu terobsesi dengan crawl budget. Fokus terlebih dahulu pada fondasi yang benar: halaman penting dapat ditemukan, dapat diakses, memiliki struktur yang jelas, dan tidak terhalang oleh masalah teknis.
Untuk website besar, pengelolaan crawl budget menjadi lebih relevan, terutama ketika website memiliki ratusan ribu URL, parameter, filter, atau struktur yang sangat kompleks.
Pada akhirnya, tujuan Technical SEO bukan membuat Googlebot mengunjungi sebanyak mungkin URL.
Tujuannya adalah membantu crawler menemukan dan mengakses halaman yang memang penting secara efisien, sementara halaman yang tidak perlu diproses tidak menghabiskan resource secara berlebihan.
Dengan crawlability yang baik, website memiliki fondasi teknis yang lebih sehat untuk melanjutkan proses indexing, pemahaman konten, dan visibilitas di mesin pencari.